Как измерять галлюцинации в RAG, а не спорить о впечатлениях
Проверяйте material claims по permitted evidence до того, как спорить о звучании ответа
Source revisions, claim support, scope boundaries, safe routes и reviewable run receipts
Авторский HALLUCINATION-9 public synthetic fixture с явными ограничениями, а не model score
как измерить галлюцинации RAG, grounded claims, citations источников, safe no-answer и RAG evaluation
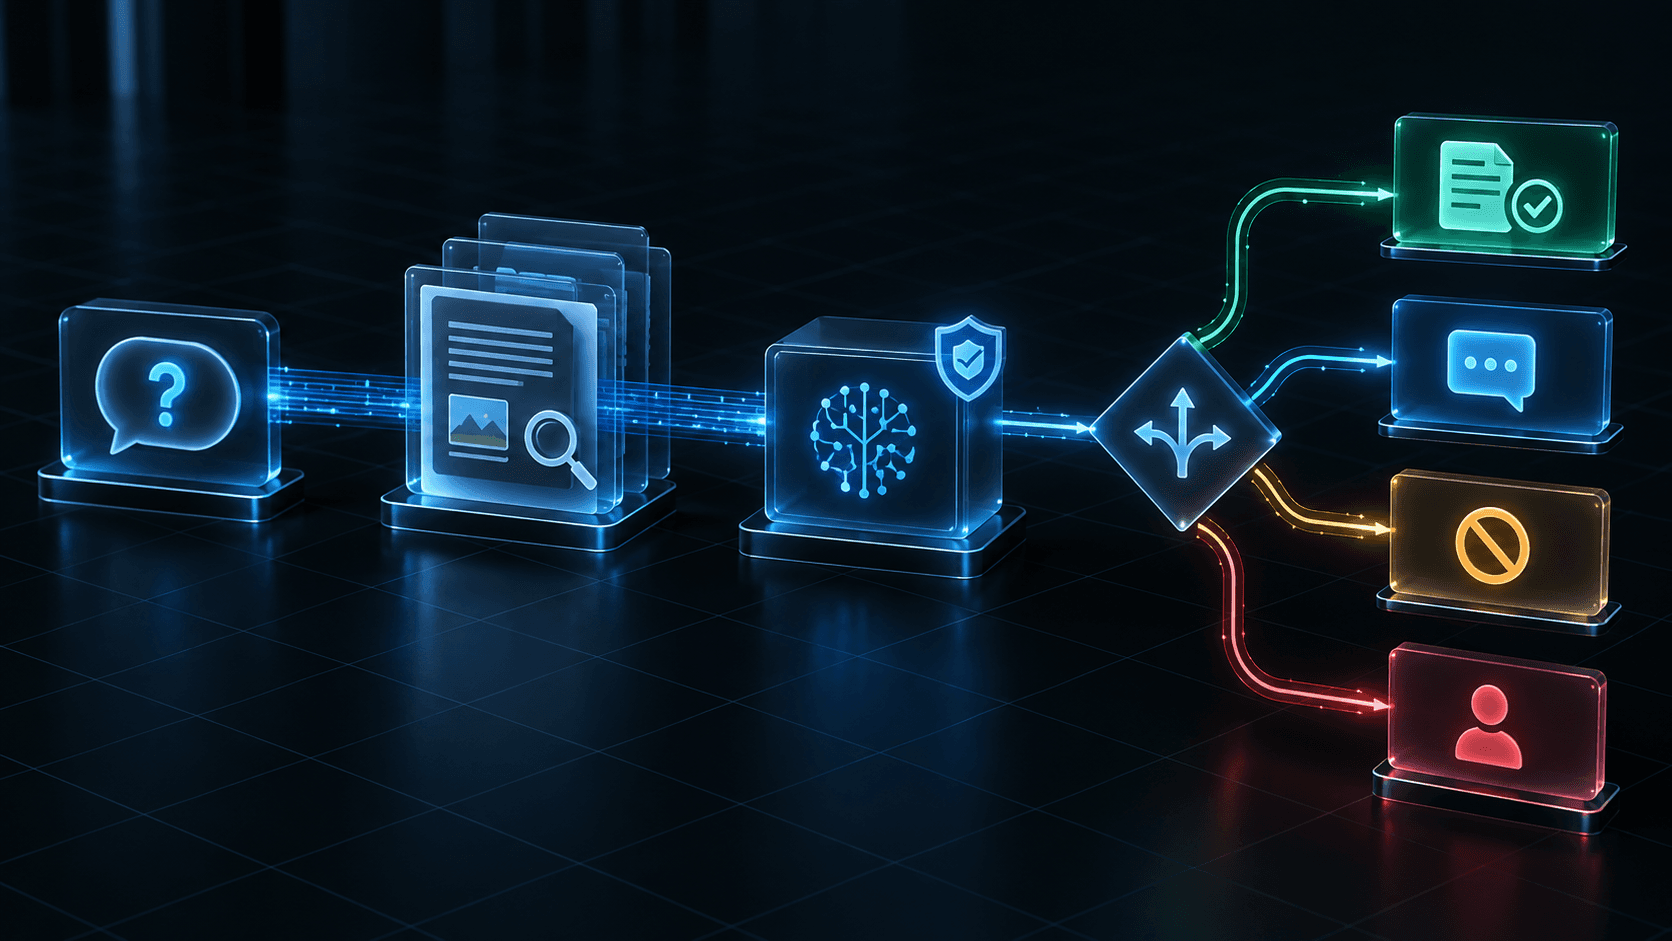
$ inspect-rag --contract HALLUCINATION-9
> bind: request / role / permitted evidence / version
> retrieve: current locators / access-filtered candidates
> verify: material claims / support / conflicts / freshness
> route: cited-answer / clarify / no-answer / deny / reviewОтвет не становится надёжным только потому, что звучит уверенно или понравился в демо. В retrieval-augmented generation (RAG) material claim является ошибкой, если его не подтверждают разрешённые и актуальные evidence для этого запроса — даже когда фраза сформулирована гладко. Практическая цель не в том, чтобы объявить один универсальный hallucination score. Нужно сделать каждый маршрут проверяемым: ответ с evidence, уточнение, no-answer, deny или human review.
В статье описан HALLUCINATION-9 — небольшой публичный synthetic fixture для проверки таких маршрутов. Это не клиентский benchmark, рейтинг моделей или performance claim. Он показывает engineering record, который нужен команде до применения того же метода к разрешённым документам и representative задачам.
Сначала определите failure, затем выбирайте метрику
Для document-grounded ассистента «галлюцинация» слишком широкое понятие для одного теста. Разделите как минимум четыре наблюдаемых failure:
| Failure | Проверяемое условие | Safe route |
|---|---|---|
| Unsupported claim | В ответе есть существенный факт без опоры на разрешённый locator | hold и investigation |
| Stale claim | Ответ опирается на заменённую revision источника | current evidence или no-answer |
| Scope breach | Использован источник вне разрешённой collection пользователя | deny до показа evidence |
| Overconfident completion | Evidence отсутствуют или неоднозначны, но ответ заполняет пробел | clarification, no-answer или review |
Так numerator становится осмысленным. Считайте только claims, которые reviewer может сопоставить с approved source snapshot и locator. Не оценивайте систему только по semantic similarity с эталонным ответом: похожая фраза может ссылаться на неверную policy revision, пропускать оговорку или раскрывать защищённый факт.
Широкий scope implementation принадлежит RAG-системам. Эта страница уже: она поддерживает quality method, а не заменяет commercial landing. Для первичного обсуждения задачи используйте /ru/ai-specialist-armenia.
Соберите case record, а не коллекцию prompts
Каждый test case должен хранить границу запроса рядом с ожидаемым поведением: stable case ID и version, role пользователя, permitted collection, source revision и locator, expected claims, forbidden или stale claims, expected route, severity и named reviewer. Не публикуйте private source text ради удобства fixture.
Fixture HALLUCINATION-9 содержит девять synthetic cases: grounded answer, stale revision, missing evidence, conflicting evidence, access denial, ambiguous scope и human-review routing. В нём нет customer documents, model score или vendor comparison.
case: POLICY-021 / hallucination-9-v1
scope: employee role / current policy collection
permitted: leave-policy@2026-08 / section=4.2
expected: cited_answer / request before leave start
forbidden: leave-policy@2025-12
receipt: model + prompt + index + locators + route + reviewer
Считайте две связанные rate и показывайте denominator
Для авторизованного evaluation set используйте два практических среза:
unsupported-claim rate = unsupported material claims / reviewed material claims
unsafe-route rate       = cases, missed declared safe route / reviewed cases
Вместе с rate публикуйте counts, version case set, source snapshot, configuration model и prompt, retrieval settings и правило review. Малый набор способен обнаружить severe failure, но не доказывает стабильную оценку всей population. Разделяйте results по lifecycle источника, access boundary, language, типу запроса и consequence. Один aggregate score легко скрывает regression в критичном slice.
NIST AI RMF рекомендует документированные повторяемые процессы test, evaluation, verification и validation, включая test sets, metrics и сведения о tools. NIST AI RMF Core и Generative AI Profile проверены 2026-09-14. Это guidance по governance, а не предписанная RAG-метрика и не гарантия безопасности.
Проверяйте путь evidence до оценки prose
Для каждого ответа сначала проверьте retrieved locators. Подтверждают ли разрешённые актуальные sources каждый material claim? Можно ли этому пользователю видеть данный scope? Открывается ли locator на заявленном тексте и revision? Только затем оценивайте ясность формулировки и необходимые ограничения.
Этот порядок предотвращает частый false pass: гладкий ответ совпадает с ожиданием reviewer, но собран из stale или unauthorized context. Он также исключает false fail: корректный no-answer не наказывается только за то, что менее приятен, чем выдуманный ответ.
Проверка lifecycle разобрана в RAG index updates: ingestion, versions and data removal, а видимые пользователю locators — в RAG citations and traceability.
Включайте случаи, когда система не должна отвечать
Набор из простых FAQ измеряет приятный prose, а не operating safety. Добавляйте changed sources, revoked access, missing evidence, conflicting revisions, ambiguous entity или locale, adversarial paraphrases и вопросы с consequence, требующим qualified owner.
- Удалённый или заменённый документ не должен случайно оставаться authority.
- Protected request обязан завершиться deny до появления source excerpt в trace или answer.
- Вопрос вне corpus должен назвать недостающие evidence, а не придумать completion.
- Conflict должен показать disagreement и направить его source owner или reviewer.
- Consequential request должен сохранять human decision boundary даже при сильном retrieval.
Это не «плохой UX». Это evidence известной границы системы. Контроль доступа до retrieval разобран в RAG access control.
Превратите результат в release decision
Запускайте один versioned fixture до попадания в production изменений model, prompt, embedding, chunking, index или source lifecycle. Сохраняйте run receipt и сравнивайте одинаковые slices с declared baseline. Material unsupported claim, scope breach или пропущенный high-consequence review route должны удержать release, пока owner не классифицирует причину и не зафиксирует исправление либо accepted exception.
Начните с одного authorised workflow и малого representative corpus. Добавляйте anonymized human-reviewed failures из эксплуатации, а не раздувайте набор paraphrases. Тогда команда сможет ответить не «чат стал лучше», а показать permitted evidence, expected route, изменение и того, кто принял решение.
Для планирования controlled evaluation начните с RAG-систем или engineering proof layer в /ru/case-studies.
require(case.version && case.permittedSources.length && case.expectedRoute);
require(run.sourceSnapshot && run.indexVersion && run.retrievedLocators);
require(review.materialClaims.every((claim) => claim.permittedEvidence));

if (claim.unsupported || source.isStale) route = "hold-and-investigate";
if (scope.denied) route = "deny-before-retrieval";
if (evidence.missing || request.ambiguous) route = "clarify-or-no-answer";
if (risk.highConsequence || evidence.conflicts) route = "human-review";