Recall, precision и context relevance: метрики retrieval RAG без путаницы
Оцените, пришло ли нужное evidence в контекст до того, как судить о тексте модели
Declared corpus, expected evidence, top-k results и inspection по срезам
Авторский RETRIEVAL-METRICS-8 example с ограничениями, а не model score
метрики retrieval RAG, recall, precision, context relevance, оценка RAG и grounded AI-системы
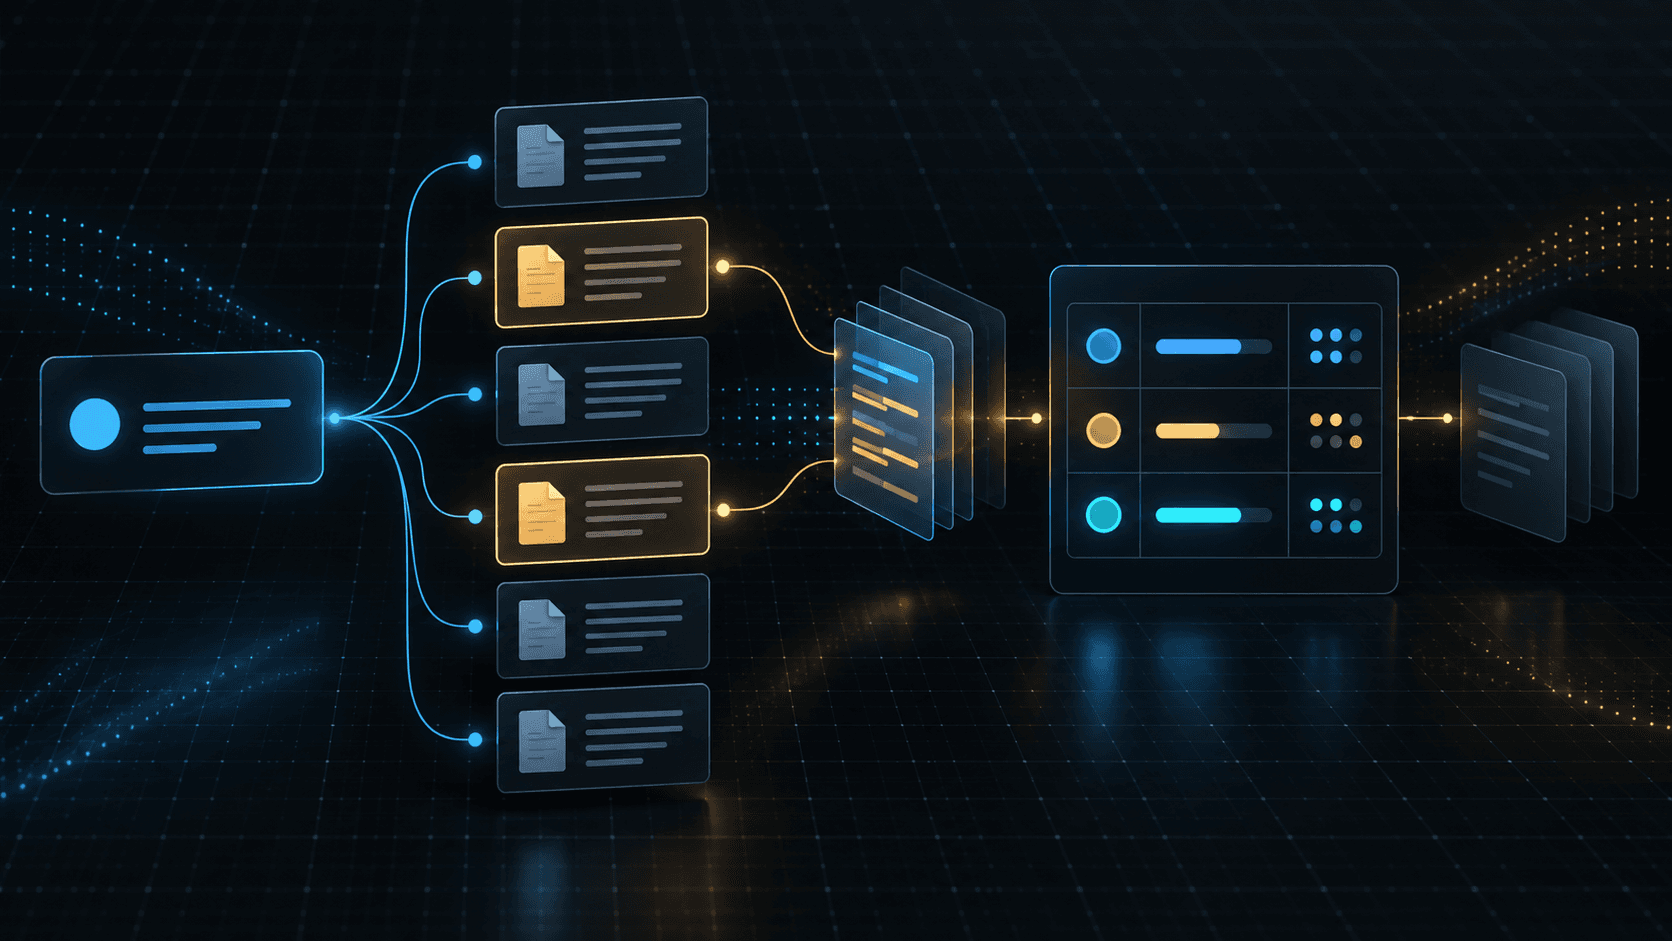
$ inspect-retrieval --contract RETRIEVAL-METRICS-8
> bind: question / permitted corpus / expected evidence
> retrieve: top-k candidates / filters / index version
> measure: recall / precision / context relevance by slice
> route: improve retrieval / clarify scope / hold release / reviewRetrieval — отдельное решение до генерации ответа
RAG может дать гладкий текст, хотя на этапе retrieval выбрал не те доказательства. Поэтому recall, precision и context relevance полезны: они проверяют переход от вопроса к контексту, который получает модель. Это не универсальный балл и не гарантия безопасного финального ответа.
Практическая единица оценки — объявленный кейс: вопрос, разрешённый корпус и его версия, доказательство, которое должно находиться, настройка top-k и ожидаемый безопасный маршрут. Без такого контракта два человека могут посчитать похожую метрику по разным документам и вложить в неё разный смысл.
Три метрики простыми словами
Recall retrieval отвечает на вопрос: нашла ли система доказательство, нужное для этого вопроса? Если актуальный пункт policy должен был попасть в кандидаты, но его нет, у этого кейса низкий recall. Recall не означает, что все выданные фрагменты полезны.
Precision retrieval спрашивает: какая доля найденных фрагментов помогает ответить именно на этот вопрос? Система может найти нужный пункт и ещё десять нерелевантных страниц. Тогда recall может быть хорошим, а precision — слабым: нужное доказательство есть, но модель получает лишний контекст.
Context relevance проверяет, релевантен и достаточен ли контекст, переданный на этап ответа. По сути это вопрос ревьюера к trace: «Может ли этот контекст подтвердить нужное утверждение?» Метрика не заменяет фактчек, контроль доступа, citations и экспертное ревью.
Один сквозной пример
Сотрудник спрашивает: «Какие командировочные расходы требуют согласования руководителя?» В актуальной policy есть нужный пункт; в старой версии есть похожий, но отменённый; в корпусе также лежат шаблоны заявок и общие новости компании.
Для кейса фиксируем актуальный пункт как expected evidence. Запускаем тот же запрос с той же trusted role, locale, фильтрами, версией индекса и top-k, что использует продукт. Затем смотрим на полученные locators.
| Наблюдение | Что это показывает | Первое действие |
|---|---|---|
| Актуального пункта нет | Сбой recall либо проблема корпуса, фильтра или запроса | Проверить lifecycle источника, access filter, chunking и формулировку запроса |
| Актуальный пункт есть среди множества лишних | Recall может быть достаточным, precision слабый | Сузить scope, улучшить metadata filters или добавить reranking |
| Найден только отменённый пункт | Сбой freshness и lifecycle, а не «слабый prompt» | Исключить или понизить retired evidence до ranking |
| Пункт есть, но без условия согласования | Контекст неполон для утверждения | Изменить границы chunk или получить связанный раздел |
Поэтому одного агрегированного числа почти всегда мало. Результат кейса нужно хранить вместе с retrieved locators и версиями источников: тогда регрессию можно воспроизвести, а не угадывать по переписке с чат-ботом.
Как работает небольшой цикл оценки
- Выберите реальные формы вопросов: ожидаемые ответы, неоднозначные запросы и честные no-answer кейсы.
- Объявите разрешённый корпус и snapshot источников. Retired, private и чужие по scope материалы исключаются до измерения ranking.
- Запишите expected evidence как стабильный locator или ID, а не только как идеальное предложение ответа.
- Запустите retrieval с реальными filters, версией индекса и top-k. Сохраните список locators.
- Посмотрите recall, precision и context relevance по полезным срезам: тип документа, язык, роль, freshness или тип вопроса.
- Отправьте сбой владельцу слоя: source coverage, lifecycle, access, chunking, query, filters, ranking, answer policy или human review.
Цель — не охота за красивым процентом, а проверяемое следующее инженерное решение.
Где метрики подходят, а где нет
Они полезны, когда есть ограниченный корпус, повторяемый набор вопросов и необходимость отделить сбой retrieval от сбоя генерации. Особенно полезно проверить retrieval до сравнения prompts или смены модели: отсутствующий источник нельзя восстановить уверенным текстом.
Они не доказывают юридическую, медицинскую, финансовую или safety-корректность. Не проверяют права доступа, не решают, является ли источник авторитетным, не измеряют пользовательскую удовлетворённость и не гарантируют правильную интерпретацию cited документа. Для этого нужны отдельные controls и квалифицированное ревью.
| Подходит | Недостаточно для |
|---|---|
| Регрессии после изменения индекса или chunking | Публичного заявления о «точности» модели |
| Сравнения retrieval-конфигураций на одних кейсах | Замены access control или ownership источника |
| Поиска stale source в top-k | Одобрения значимого совета или внешнего действия |
| Выявления вопроса для безопасного no-answer | Выдачи aggregate score за клиентский результат |
Минимальная запись RETRIEVAL-METRICS-8
Ниже синтетическая запись полей, которые стоит сохранять. Это пример метода, а не benchmark и не результат производительности.
{
  "case_id": "policy-approval-current-01",
  "question": "Какие командировочные расходы требуют согласования?",
  "permitted_corpus": "policy-snapshot-2026-09-10",
  "expected_locators": ["travel-policy:v4#approval"],
  "run": {
    "index_version": "idx-42",
    "filters": ["role:employee", "locale:ru", "state:current"],
    "top_k": 5,
    "retrieved_locators": ["travel-policy:v4#approval", "expenses-guide:v2#receipt"]
  },
  "review": { "route": "inspect-precision-before-release" }
}
Если travel-policy:v4#approval отсутствует, сначала исследуйте coverage, lifecycle, filters и retrieval. Если он есть, но окружён нерелевантным контекстом, исследуйте precision и упаковку контекста. Если недостаточно роли пользователя или ясности запроса, маршрут должен быть clarification или safe no-answer, а не скрытое расширение retrieval.
Практический следующий шаг
Начните с 10–20 кейсов из повторяющихся реальных вопросов и отчётов о сбоях. Версионируйте кейсы и источники, сохраняйте trace и проверяйте изменения по срезам до релиза. Тогда у product owner и инженеров появляется общий язык: проблема — не просто «RAG плохо ответил», а конкретный сбой выбора evidence с понятным следующим владельцем.
Для более широкого устройства системы смотрите гайд по RAG-системам и страницу AI-специалист в Армении. Эта статья поддерживает service pages критериями оценки retrieval и не заменяет их широкий коммерческий интент.
require(case.question && case.permittedCorpus && case.expectedEvidence);
require(run.indexVersion && run.retrievedLocators && run.topK);
require(metrics.slices.every((slice) => slice.denominatorIsDeclared));

if (expectedEvidence.isMissing) route = "fix-corpus-or-label-no-answer";
if (retrieval.scopeIsWrong) route = "repair-filter-before-tuning-ranking";
if (precision.low && recall.high) route = "rerank-or-narrow-context";
if (recall.low) route = "inspect-coverage-query-and-retrieval";